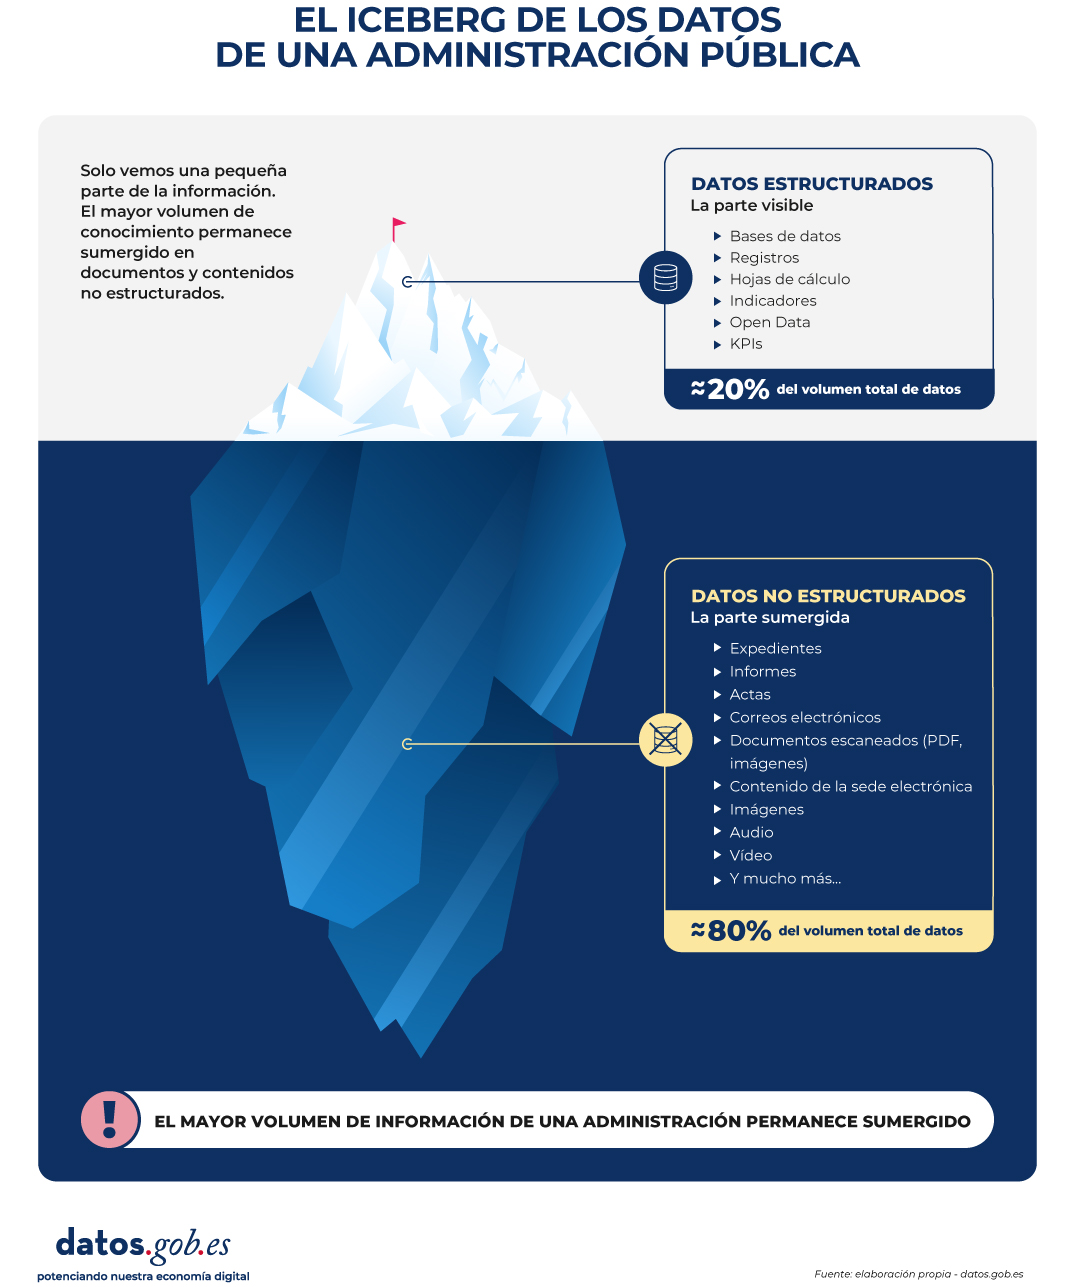
La paradoja es evidente: la mayor parte del conocimiento de una administración no está en sus bases de datos, sino sumergida en sus documentos. Durante muchos años esa parte del iceberg apenas podía aprovecharse. Hoy, sin embargo, la situación ha cambiado radicalmente.
El valor latente que se está dejando pasar
Ignorar la parte sumergida del iceberg supone desperdiciar uno de los mayores activos de información del sector público. En esos contenidos se documentan la experiencia acumulada durante años, el conocimiento de los empleados públicos, las relaciones entre expedientes y buena parte del contexto que nunca llega a almacenarse en una base de datos. Su aprovechamiento tiene, por ello, un impacto directo y transversal en la gestión pública.
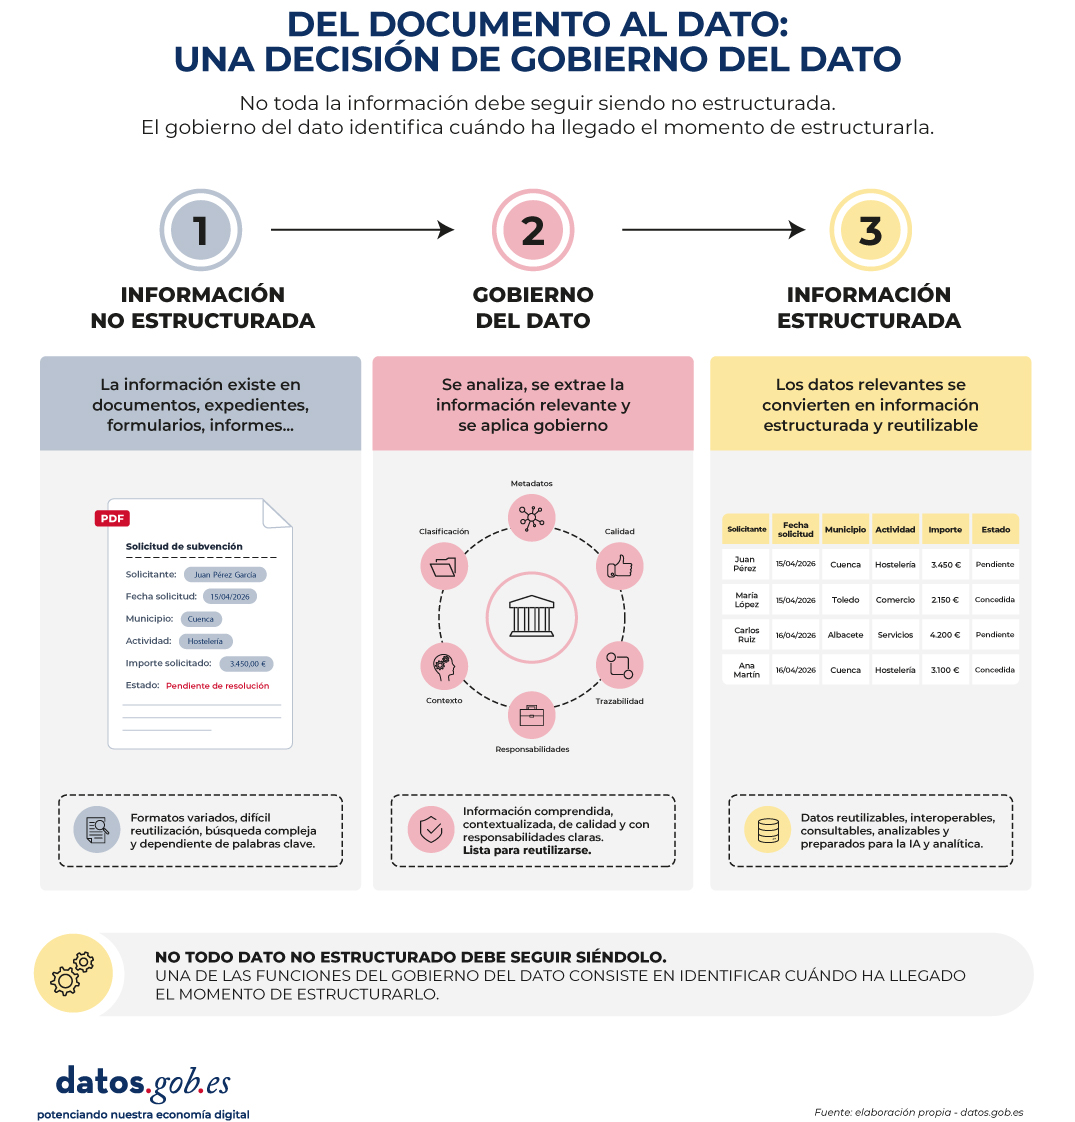
Cuando esa información puede localizarse, entenderse y relacionarse, un expediente deja de ser únicamente un conjunto de documentos para convertirse en una fuente de conocimiento reutilizable. El recorrido es siempre el mismo: los documentos contienen conocimiento institucional en forma de contexto, decisiones, criterios y evidencias, y es el gobierno del dato el que permite transformar ese conocimiento en valor público. Esto se traduce en mejores servicios para la ciudadanía, una mayor trazabilidad de la actividad administrativa, más transparencia, una mayor eficiencia interna y una mejor reutilización del conocimiento institucional.
Esta puesta en valor conecta, además, con una obligación legal muy concreta: el principio de "una sola vez", recogido en el artículo 28.2 de la Ley 39/2015, que reconoce el derecho de la ciudadanía a no aportar documentos que ya obren en poder de cualquier administración. Hacer efectivo ese derecho exige que la información que la administración ya posee, con frecuencia en forma de documentos, pueda localizarse, interpretarse e intercambiarse entre organismos: cada vez que se solicita a un ciudadano un dato que ya figura en un expediente, el problema no es normativo, sino de gestión e interoperabilidad de la información.
Pero hay un factor que ha convertido esta necesidad en una prioridad estratégica: la inteligencia artificial. Estos contenidos constituyen hoy la principal materia prima para las aplicaciones de IA, especialmente aquellas basadas en el procesamiento del lenguaje natural (PLN, por sus siglas en inglés) y los Grandes Modelos de Lenguaje (LLM, por sus siglas en inglés).
El aprovechamiento de la información no estructurada, sin embargo, no comenzó con la inteligencia artificial generativa. Desde hace años se utilizan técnicas como el reconocimiento óptico de caracteres, los procesos ETL (extraer, transformar, cargar, por sus siglas en inglés), el web scraping, las expresiones regulares, las taxonomías, los motores de reglas y las técnicas clásicas de procesamiento del lenguaje natural para extraer, clasificar, normalizar y trasladar información documental a estructuras explotables. Estas aproximaciones continúan siendo especialmente eficaces cuando las fuentes son relativamente homogéneas, los patrones son estables y las reglas de extracción pueden definirse de forma precisa. La inteligencia artificial no sustituye necesariamente estas técnicas, sino que amplía su alcance y permite abordar contenidos más variables, ambiguos o difíciles de procesar mediante reglas previamente definidas.
Hasta hace pocos años, gran parte de esta información podía explotarse mediante técnicas tradicionales, pero hacerlo exigía procesos muy específicos, dependientes del formato y difíciles de escalar o mantener cuando aumentaban la diversidad y la complejidad documental. Los documentos se generaban y almacenaban en sistemas y formatos muy diversos, su localización dependía a menudo de palabras clave o rutas de carpetas y la comprensión de los contenidos que no podían procesarse mediante reglas exigía una lectura manual lenta y costosa.La irrupción de la inteligencia artificial generativa ha cambiado completamente este escenario: hoy es posible resumir documentos, clasificar expedientes, extraer entidades relevantes, detectar relaciones entre documentos o responder preguntas sobre normativa de forma automática. La IA no ha creado el dato no estructurado; simplemente ha hecho posible aprovechar un patrimonio documental que llevaba décadas esperando su oportunidad.
El iceberg, por tanto, ya no es solo una metáfora sobre lo que no vemos: es una descripción bastante precisa de dónde está el valor que todavía no estamos capturando.
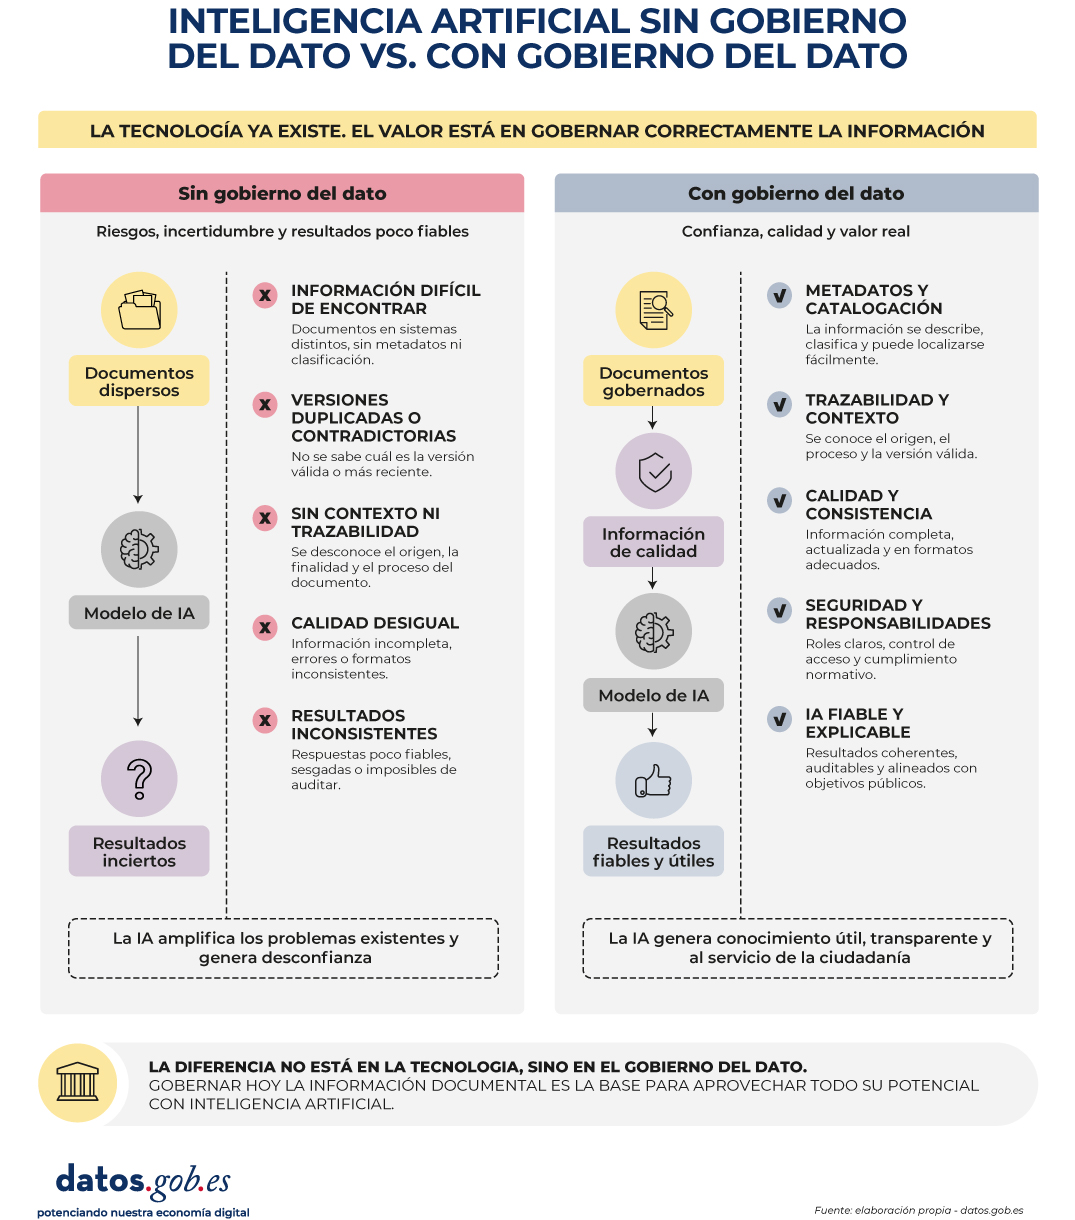
Sin embargo, existe un error frecuente: pensar que disponer de modelos de inteligencia artificial es suficiente para aprovechar todo ese conocimiento. Sin embargo, no lo es.